AI: Intelligente Suche und Routing von Anfragen mit Tool Calling
Im Verlauf früherer Experimente mit AI im Projekt serdg.net wurden Mechanismen zur Generierung von embeddings, semantischer Suche und RAG (Retrieval-Augmented Generation) implementiert.
Dadurch erhielt die Anwendung die Fähigkeit, nicht nur Artikel anhand semantischer Ähnlichkeit zu finden, sondern auch Antworten auf Benutzerfragen auf Basis der veröffentlichten Materialien zu erstellen.
Der nächste Entwicklungsschritt bestand in der Zusammenführung der bestehenden Möglichkeiten in einer einheitlichen Oberfläche unter Verwendung von AI Tool Calling — einem Mechanismus, der es dem Sprachmodell erlaubt, je nach Inhalt der Benutzeranfrage geeignete Werkzeuge der Anwendung auszuwählen. Die Hauptaufgabe war, dem Benutzer die Möglichkeit zu geben, Artikel zu suchen, Fragen zu deren Inhalt zu stellen und diese Vorgänge zu kombinieren, ohne dass er selbst den Verarbeitungsmodus wählen muss.
Problemerkennung und Aufgabenstellung
Mit der Weiterentwicklung des Projekts serdg.net wurde schrittweise der Funktionsumfang für die Arbeit mit Artikeln erweitert. Zunächst bot die Anwendung Zugang zu veröffentlichten Materialien, später kamen Mechanismen zur Generierung von embeddings, semantische Suche und die Beantwortung von Fragen mittels RAG hinzu.
Daraus ergaben sich mehrere unabhängige Interaktionsweisen mit dem Inhalt der Seite, von denen jede ihre eigene Aufgabe löste.
Die Suche nach Artikeln und die Generierung von Antworten auf deren Basis sind jedoch grundlegend verschiedene Operationen, auch wenn der Benutzer entsprechende Anfragen in identischer Form — in natürlicher Sprache — formulieren kann. Zum Beispiel impliziert die Anfrage „Найди статьи о .NET на немецком языке за 2026 год“ eine normale Suche mit Filterung und Paginierung, während die Frage „Как использовался Azure Container Apps в проектах?“ die Analyse der veröffentlichten Materialien und die Erstellung einer Antwort mittels RAG erfordert. Es ist auch ein komplexeres Szenario möglich: „Найди статьи про OpenAI и сравни описанные в них подходы“. In diesem Fall muss zunächst das passende Material identifiziert und anschließend dessen Inhalt analysiert werden.
Eine mögliche Lösung wäre die Erstellung separater Oberflächen für Suche, kontextbezogene Fragen und kombinierte Operationen gewesen. Ein solcher Ansatz würde jedoch vom Benutzer verlangen, die internen Mechanismen der Anwendung zu verstehen und selbst das passende Werkzeug auszuwählen. Stattdessen wurde entschieden, das bestehende Feld Any question zu erweitern und in einen universellen Interaktionspunkt mit der Funktionalität der Seite zu verwandeln.
Die Hauptaufgabe bestand in der Implementierung eines Mechanismus, der die Benutzeranfrage interpretieren und automatisch die notwendige Abfolge von Aktionen bestimmen kann. Dabei war es erforderlich, das bestehende RAG beizubehalten, Suche und Filterung von Artikeln anhand natürlicher Anfragen hinzuzufügen, kombinierte Operationen zu unterstützen und vorhandene Dienste wiederzuverwenden, ohne die Geschäftslogik zu duplizieren. Weitere Anforderungen umfassten die Minimierung der Anzahl der Aufrufe an die LLM, Kontrolle der damit verbundenen Kosten und Erhalt der vertrauten Ergebnisdarstellung in Angular.
Besonderes technisches Interesse galt dem Entscheidungsmechanismus. Das Sprachmodell sollte das passende Werkzeug bestimmen und die Parameter für dessen Aufruf formen, ohne direkten Zugriff auf die Datenbank oder die interne Infrastruktur der Anwendung zu erhalten. Damit bestand die Aufgabe nicht darin, die Geschäftslogik dem AI zu übergeben, sondern eine intelligente Routing-Ebene zwischen Benutzeroberfläche und den bereits implementierten Diensten zu schaffen. Für diese Aufgabe wurde der Mechanismus AI Tool Calling gewählt.
Theoretische Ausarbeitung: AI Tool Calling
Zur Zusammenführung verschiedener Mechanismen zur Verarbeitung von Benutzeranfragen wurde der Ansatz AI Tool Calling (auch bekannt als Function Calling) gewählt. Die Kernidee besteht darin, dass das Sprachmodell nicht nur Text generiert, sondern auch bestimmen kann, welche Operationen der Anwendung zur Lösung der gestellten Aufgabe ausgeführt werden müssen. Dabei erhält das Modell selbst keinen direkten Zugriff auf die Geschäftslogik oder Infrastruktur: Es wählt das passende Werkzeug aus und formt die Parameter für dessen Aufruf, während die Ausführung unter Kontrolle der Anwendung bleibt.
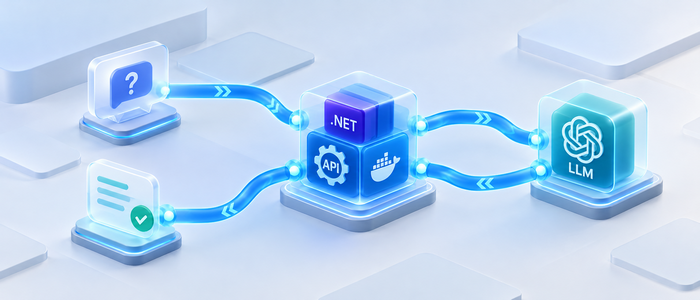
Beim üblichen Zusammenspiel mit einer LLM sendet der Benutzer eine Textanfrage, auf deren Basis das Modell eine Antwort generiert. Vereinfacht sieht dieser Prozess folgendermaßen aus:
Tool Calling erweitert dieses Schema durch die Bereitstellung von Beschreibungen der verfügbaren Werkzeuge für das Modell. Jedes Werkzeug hat eine bestimmte Aufgabe, eine Menge von Parametern und Nutzungsregeln. Nach Erhalt der Benutzeranfrage stimmt die LLM diese mit den Werkzeugbeschreibungen ab und kann einen strukturierten Aufruf mit den notwendigen Argumenten bilden. Die Anwendung überprüft die erhaltenen Daten, führt die entsprechende Operation aus und verarbeitet deren Ergebnis. Je nach Szenario kann das Ergebnis direkt an den Benutzer zurückgegeben oder zur finalen Antworterstellung erneut an das Modell übergeben werden.
Das prinzipielle Unterscheidungsmerkmal liegt in der Trennung von Entscheidungsfindung und Ausführung der Operation. Die LLM ermittelt die Absicht des Benutzers und schlägt den passenden Aufruf vor, während die Anwendung selbst entscheidet, ob die Operation zulässig ist, die Argumente prüft und den entsprechenden Dienst aufruft. Dadurch wird das Sprachmodell als intelligenter Routing-Mechanismus eingesetzt, nicht als Ersatz für die bestehende Geschäftslogik.
Der Vorteil dieses Ansatzes ist besonders bei der Verarbeitung natürlicher Sprache erkennbar. Beispielsweise kann man den Satz „Покажи немецкие статьи про Docker, опубликованные за этот год“ versuchen mit Schlüsselwörtern und vordefinierten Regeln zu analysieren. Eine solche Implementierung wird jedoch schnell kompliziert, weil identische Absichten ganz unterschiedlich formuliert werden können, auch in mehreren Sprachen. Die Nutzung einer LLM ermöglicht es, die Bedeutung der Anfrage zu interpretieren und in einen strukturierten Parametersatz zu überführen:
language = "de"
  text = "Docker"
  dateFrom = "2026-01-01"
  dateTo = "2026-12-31"
Nach Erhalt dieser Parameter erfolgt die weitere Verarbeitung durch die üblichen Dienste der Anwendung. Somit ist das Modell für die Interpretation der Benutzerabsicht verantwortlich, während Suche, Filterung, Sortierung und Paginierung deterministische Operationen bleiben. Zur korrekten Verarbeitung relativer Zeitangaben wie „in diesem Jahr“, „im letzten Monat“ oder „in den letzten 12 Monaten“ wird dem Router zusätzlich das aktuelle Datum übergeben. Dadurch kann das Modell den zeitlichen Kontext der Anfrage berücksichtigen, obwohl die Richtigkeit der gebildeten Grenzen weiterhin geprüft werden muss.
Eine weitere Möglichkeit von Tool Calling ist die sequenzielle Nutzung mehrerer Werkzeuge. Beispielsweise kann es für die Beantwortung einer kombinierten Anfrage notwendig sein, zunächst passende Artikel zu finden, dann relevante Fragmente ihres Inhalts zu bestimmen und erst danach die Antwort mittels RAG zu generieren. Solche Operationen können durch mehrere aufeinanderfolgende Werkzeugaufrufe erfolgen oder als vordefiniertes Szenario auf der Anwendungsseite zusammengefasst werden. Die zweite Variante ist besonders praktisch, wenn die Ausführungsreihenfolge im Voraus bekannt ist und keine eigenständige Planung durch das Sprachmodell erfordert.
Aus diesem Grund war für die betrachtete Aufgabe der Einsatz eines vollständigen AI-Agenten nicht erforderlich. Die Anzahl der verfügbaren Operationen ist begrenzt, ihre Aufgaben sind vorab definiert und die möglichen Ausführungssequenzen sind relativ einfach. Gesteuertes Tool Calling mit einem festen Satz von Werkzeugen erlaubt, die Hauptvorteile intelligenter Routing-Funktionen zu nutzen, ohne die zusätzliche Komplexität autonomer Agentensysteme.
Gleichzeitig garantiert Tool Calling nicht absolute Korrektheit bei der Verarbeitung von Anfragen. Das Sprachmodell kann die Benutzerabsicht falsch interpretieren, ein ungeeignetes Werkzeug wählen oder fehlerhafte Argumente bilden. Zusätzliche Komplikationen entstehen durch Token-Kosten, Verzögerungen bei Aufrufen der LLM und die Notwendigkeit, Manipulationsversuche der internen Logik der Anwendung durch Benutzereingaben abzuwehren.
Daher erfordert eine verlässliche Implementierung die Verwendung einer strikt definierten Liste verfügbarer Werkzeuge, verpflichtende Validierung der Argumente, Begrenzung der Anzahl von Aufrufen und Kontrolle des gesamten Token-Budgets. Kritische Regeln müssen durch Programmcode sichergestellt werden, nicht allein durch Anweisungen an das Sprachmodell. So lässt sich die Flexibilität der LLM zur Interpretation von Anfragen nutzen und zugleich Vorhersehbarkeit und Steuerbarkeit der tatsächlichen Ausführung gewährleisten.
Zusammengefasst stellt AI Tool Calling einen Mechanismus zur Interaktion zwischen Sprachmodell und traditionellen Programmdiensten dar. Sein Hauptwert liegt nicht in der Übergabe der Steuerung der Anwendung an die künstliche Intelligenz, sondern in der Möglichkeit, frei formulierte Benutzeranfragen in konkrete, kontrollierte Operationen zu überführen. Dieses Prinzip bildete die Grundlage der Implementierung der intelligenten Routing-Funktion in serdg.net.
Implementierung der Suche und Filterung von Artikeln
Der erste praktische Schritt war die Vorbereitung eines Suchmechanismus, der sowohl direkt von der Anwendung als auch über AI Tool Calling genutzt werden kann. Anstatt eine separate Implementierung für das Sprachmodell zu erstellen, wurde die bestehende Geschäftslogik verwendet und um eine spezielle Schicht zur Verarbeitung von Suchanfragen ergänzt. Dieser Ansatz vermeidet Funktionsduplizierung und gewährleistet einheitliche Suchregeln unabhängig davon, wie die Suche aufgerufen wird.
Zur Übermittlung der Kriterien wird ein strukturiertes Anfrage-Modell verwendet, das Parameter für Textsuche, Sprache, Zeitspanne, Sortierung und Paginierung enthält. Alle Bedingungen können innerhalb einer Anfrage kombiniert werden, und der Verarbeitungsmechanismus ist unabhängig von der Datenquelle — Benutzeroberfläche oder Sprachmodell.
| Parameter | Bedeutung |
|---|---|
text |
Textsuche |
language |
Sprache des Artikels: en, de oder ru |
dateFrom |
Startdatum |
dateTo |
Enddatum |
sort |
Sortierung: newest oder oldest |
page |
Seitennummer |
pageSize |
Seitengröße |
Die erhaltenen Parameter werden validiert, normalisiert und in Bedingungen umgewandelt, die vom bestehenden Suchmechanismus verstanden werden. Ein vereinfachtes Beispiel zur Vorbereitung dieser Bedingungen in C# sieht wie folgt aus:
var searchParameters = new
  {
    SearchQuery = request.Text,
    LanguageCode = request.Language,
    CreatedFrom = ParseDate(request.DateFrom),
    CreatedBefore = ParseDate(request.DateTo)?.AddDays(1),
    OrderBy = request.Sort == "oldest"
      ? "CreationDate asc,Id asc"
      : "CreationDate desc,Id desc",
    IsPublished = true,
    IsHidden = false,
    Page = request.Page!.Value,
    PageSize = request.PageSize!.Value
  };
Die Suchbedingungen werden gemeinsam angewendet: Die Anfrage kann gleichzeitig die Sprache der Artikel einschränken, eine Suchphrase enthalten und einen Zeitbereich festlegen. Die Textzuordnung erfolgt anhand des Titels, der Kurzbeschreibung und des HTML-Inhalts der jeweiligen Lokalisierung. In diesem Fall wird eine gewöhnliche Textsuche verwendet, während die Suche nach semantischer Nähe Aufgabe eines separaten Mechanismus auf Basis von embeddings bleibt.
Besondere Eigenheiten gelten für die Filterung nach Datumsangaben. Da im bestehenden Modell kein separates Veröffentlichungsdatum vorhanden ist, wird die Suche anhand des CreationDate — dem Erstellungsdatum des Artikels — durchgeführt.
Um den letzten Tag einzubeziehen, wird die obere Grenze des Zeitintervalls in den Beginn des folgenden Tages umgewandelt. Beispielsweise wird bei einer Suche bis einschließlich 31. Dezember als ausschließende obere Grenze der 1. Januar des Folgejahres übergeben.
Weil Suchparameter von einer LLM gebildet werden können, sind bestimmte Einschränkungen vorgesehen. Es sind nur bestimmte Felder und Sortierwerte erlaubt, und die Bedingungen IsPublished = true und IsHidden = false gewährleisten die Auswahl ausschließlich veröffentlichter und sichtbarer Artikel.
Die Standardseitengröße beträgt 20 Einträge, das maximal zulässige Limit liegt bei 50. Für stabile Paginierung wird die Sortierung nach Datum durch eine zusätzliche Sortierung nach Id ergänzt, was eine eindeutige Reihenfolge für Artikel mit gleichem Erstellungsdatum ermöglicht.
Als Ergebnis entstand ein universeller Suchmechanismus, der sowohl traditionellen Komponenten der Anwendung als auch Werkzeugen des AI Tool Calling gleichermaßen zur Verfügung steht. Die gesamte Datenverarbeitung verbleibt in der bestehenden Programmschicht, und das Sprachmodell ist lediglich für die Umwandlung der Benutzeranfrage in strukturierte Parameter zuständig. Dadurch lassen sich die Suchfunktionen erweitern, ohne die Architektur der AI-Integration wesentlich zu verändern.
Implementierung des AI Routing
Nach der Vorbereitung des Suchmechanismus war der nächste Schritt die Implementierung der intelligenten Weiterleitung (Routing) von Benutzeranfragen. Die Hauptaufgabe bestand darin, auf Basis natürlicher Sprache die erforderliche Operation zu bestimmen und deren Ausführung an die entsprechende Komponente der Anwendung zu übergeben.
Zu diesem Zweck wurden drei Werkzeuge definiert: SearchArticles für Suche und Filterung von Artikeln, AskArticles für kontextbezogene Antworten über RAG und SearchAndAskArticles für kombinierte Anfragen, die zunächst das Auffinden von Materialien und anschließend deren inhaltliche Analyse vorsehen.
Dieses Set deckt die wichtigsten Interaktionsszenarien mit der Anwendung ab, ohne eine übermäßige Komplexität bei der Auswahl der Operation zu erzeugen.
Das Routing wurde serverseitig unter Verwendung von IChatClient aus Microsoft.Extensions.AI realisiert. Die verfügbaren Werkzeuge werden über AIFunctionFactory.CreateDeclaration registriert, und ihre Parameter werden mittels JSON Schema beschrieben.
Dadurch kann dem Sprachmodell nicht nur der Name einer Operation, sondern auch die Struktur der zulässigen Argumente, die benötigten Datentypen und die Bedeutung jedes Werkzeugs übergeben werden.
Bei der Verarbeitung einer Anfrage erhält das Modell Systemanweisungen, die Benutzerbotschaft und Beschreibungen der verfügbaren Werkzeuge. Auf Basis dieser Informationen bestimmt es die passende Operation und formt strukturierte Argumente für deren Ausführung. Ein vereinfachtes Beispiel für die Konfiguration des Aufrufs an die LLM sieht so aus:
var response = await client.GetResponseAsync(
    state.Messages,
    new ChatOptions
    {
      Tools = Tools,
      AllowMultipleToolCalls = false,
      MaxOutputTokens = limits.MaxOutputTokens,
      ResponseFormat = ChatResponseFormat.Json
    },
    ct);
Ein wichtiges Merkmal ist die Trennung von Werkzeugauswahl und dessen tatsächlicher Ausführung. Das Modell bildet die Anfrage zur Ausführung einer bestimmten Operation, danach prüft die Anwendung die übermittelten Parameter und führt die erforderlichen Aktionen selbst aus. Das Ergebnis kann direkt an den Benutzer zurückgegeben oder für eine weitere Verarbeitung verwendet werden.
Das Funktionsprinzip lässt sich gut anhand der Anfrage „Найди статьи про Azure Container Apps на русском языке и объясни, как в них организовано развёртывание приложений“ veranschaulichen. In diesem Fall erwartet der Benutzer sowohl eine Liste passender Materialien als auch eine Erklärung auf Basis ihres Inhalts.
Folglich ist die am besten geeignete Operation SearchAndAskArticles. In vereinfachter Form könnten die Modellentscheidung und die gebildeten Argumente wie folgt aussehen:
{
    "tool": "SearchAndAskArticles",
    "arguments": {
    "text": "Azure Container Apps",
    "language": "ru",
    "sort": "newest"
    }
  }
Nach Erhalt und Prüfung der Argumente führt die Anwendung die Suche gemäß den angegebenen Bedingungen aus. Anschließend werden die Identifikatoren der gefundenen Materialien an den RAG-Mechanismus übergeben, wodurch der Bereich für die weitere Suche nach relevanten Fragmenten eingeschränkt wird. Zuerst wird also eine Auswahl von Artikeln gebildet, die der Benutzeranfrage entsprechen, und erst danach wird innerhalb dieser Auswahl eine semantische Suche durchgeführt. Das gewährleistet Konsistenz der Ergebnisse: Die generierte Antwort basiert auf Materialien, die den ursprünglichen Suchkriterien genügen.
Da unterschiedliche Werkzeuge unterschiedliche Informationsrepräsentationen erfordern, liefert der Server ein strukturiertes Ergebnis mit Angabe seines Typs im Feld resultType. Für eine normale Suche wird SearchResult verwendet, das eine Artikelliste und Paginierungsdaten enthält.
Eine kontextbezogene Frage liefert ein AnswerResult mit Antworttext und Quellenangaben. Die kombinierte Operation erzeugt ein CombinedResult, das beide Strukturen vereint.
Ein vereinfachtes Beispiel für die Struktur einer kombinierten Antwort:
{
    "resultType": "CombinedResult",
    "status": "answered",
    "answer": "...",
    "sources": [],
    "articles": {
    "items": [],
    "totalItems": 0,
    "page": 1,
    "pageSize": 20,
    "totalPages": 0
    },
    "search": {
    "text": "Azure Container Apps",
    "language": "ru",
    "sort": "newest",
    "page": 1,
    "pageSize": 20
    },
    "coverageLimited": true
  }
Die gezeigte Struktur veranschaulicht das Prinzip der Zusammenführung von Such- und Generierungsergebnissen; der Inhalt der Felder answer, sources und articles hängt von den tatsächlich gefundenen Materialien ab.
Zusätzlich werden normalisierte Suchparameter zurückgegeben, die vom Client erneut genutzt werden können, beispielsweise beim Wechsel der Seiten. Das Feld coverageLimited erlaubt anzuzeigen, dass die generierte Antwort auf einer begrenzten Auswahl von Materialien basiert.
Für die Integration mit Angular wurde das bestehende Feld Any question an einen neuen Server-Endpoint angeschlossen, der alle drei Szenarien unterstützt.
Das erhaltene resultType bestimmt die Art der Darstellung: Suchergebnisse werden als Artikel-Karten angezeigt, kontextbezogene Antworten als Text mit Quellenverweisen, und das kombinierte Ergebnis enthält beide Elemente gleichzeitig.
Dabei werden Suchergebnisse nicht vom Sprachmodell in normalen Text umgewandelt. Zur Darstellung werden die bestehenden Angular-Komponenten erneut verwendet, wodurch das vertraute Erscheinungsbild der Karten und die Navigationsmechanismen erhalten bleiben. Textgenerierung kommt nur dort zum Einsatz, wo tatsächlich eine Analyse der Materialien erforderlich ist.
Durch AI Routing konnten mehrere unabhängige Funktionalitäten der Anwendung in einer einheitlichen Benutzeroberfläche zusammengeführt werden. Das Sprachmodell bestimmt die Benutzerabsicht und wählt das passende Werkzeug, während Suche, Kontextentnahme und Ergebnisbildung spezialisierten Mechanismen überlassen bleiben. So lassen sich die Vorteile natürlicher Sprache nutzen, ohne die Grundprinzipien der bestehenden Anwendung zu verändern.
Architekturlösungen und interessante Implementierungsdetails
Bei der Implementierung der neuen Funktionalität war die Hauptaufgabe, die bestehende Anwendungsarchitektur maximal zu nutzen und die Verantwortlichkeiten zwischen den Komponenten beizubehalten. Infolgedessen ist ArticleRequestRouter für die Interpretation der Anfrage und die Auswahl des passenden Werkzeugs zuständig, ArticleQueryService führt Suche und Filterung der Artikel aus und ArticleAnswerService sorgt für die Arbeit mit RAG. Diese Trennung erlaubt es, jede Komponente unabhängig weiterzuentwickeln, vereinfacht das Testen und ermöglicht das Hinzufügen neuer Werkzeuge ohne wesentliche Änderungen an der vorhandenen Geschäftslogik.
Einer der wichtigsten Entwurfsentscheidungen war die Einschränkung des RAG-Suchbereichs bei der Verarbeitung kombinierter Anfragen. Dazu wird das Objekt RagSearchScope verwendet, das die Sprache und die Identifikatoren der Artikel enthält, in denen gesucht werden soll:
public sealed record RagSearchScope(string Language,IReadOnlyList<int> TopicIds);Nach einer normalen Suche werden die Identifikatoren der Artikel der aktuellen Ergebnissseite in dieses Objekt übergeben. Anschließend sucht RAG ausschließlich unter den ausgewählten Materialien nach relevanten Fragmenten. Die Filterung erfolgt dabei noch vor der Sortierung nach vektorieller Ähnlichkeit und der Auswahl der Top-K-Fragmente. Somit bezieht sich die gefundene Information auf Artikel, die den ursprünglichen Suchkriterien entsprechen. Eine gesonderte Behandlung einer leeren Auswahl ist vorgesehen: Falls keine passenden Artikel vorhanden sind, wechselt RAG nicht automatisch auf die gesamte Wissensdatenbank.
Weil die Auswahl der Werkzeuge durch das Sprachmodell erfolgt, ist eine Kontrolle seines Handelns notwendig. ArticleRequestRouter überprüft die Namen der aufgerufenen Werkzeuge und die übergebenen Argumente und lehnt unbekannte Operationen sowie inkorrekte Parameter ab.
Die Interaktion ist auf vier Runden mit dem Router-Modell begrenzt, jeweils einem tool call pro Runde und maximal drei Werkzeugaufrufen. Zusätzlich werden Ein- und Ausgabetoken, das gesamte Token-Budget, Ausführungszeit und Anfragefrequenz überwacht.
Diese Beschränkungen sorgen für vorhersehbares Verhalten der Anwendung, reduzieren das Risiko missbräuchlicher Werkzeugverwendung und ermöglichen die Kontrolle der AI-Kosten.
Aus demselben Grund wurde die Arbeit mit Paginierung optimiert. Nach der Erstanforderung liegen bereits die strukturierten Suchparameter vor, die mittels LLM ermittelt wurden. Daher ist beim Wechsel auf die nächste Seite kein erneuter Aufruf des Modells und keine erneute Interpretation derselben Anfrage erforderlich.
Zusammen mit den Ergebnissen erhält der Client normalisierte Filter, die bei nachfolgenden Seitenanfragen mit geänderter Seitennummer verwendet werden. ArticleRequestRouter erkennt dieses Szenario und wendet sich direkt an ArticleQueryService, wodurch die LLM umgangen wird. Das reduziert Latenzen und Token-Kosten.
Wenn die ursprüngliche Anfrage kombiniert war, bleibt die generierte Antwort beim Seitenwechsel erhalten und wird nicht neu berechnet.
Dieser Ansatz hat jedoch eine wichtige Einschränkung. Die kombinierte Antwort wird auf Basis der Artikel der aktuellen Suchergebnisseite erstellt, und RAG wählt zusätzlich daraus die relevantesten Fragmente unter Berücksichtigung des verfügbaren Token-Budgets aus.
Folglich ist die erhaltene Antwort nicht als umfassende Analyse aller gefundenen Materialien zu verstehen. Um diese Einschränkung deutlich zu machen, wurde dem Ergebnismodell die Kennzeichnung coverageLimited hinzugefügt. Ist dieser Wert auf true gesetzt, zeigt Angular eine entsprechende Benachrichtigung an.
Dies ist ein wichtiger Aspekt beim Design von AI-Oberflächen: Der Benutzer sollte nicht nur das Ergebnis der Anfrageverarbeitung kennen, sondern auch die Grenzen der zugrundeliegenden Informationsbasis.
Eine weitere Besonderheit ist die Unterstützung mehrerer Sprachen. Da serdg.net Artikel auf Russisch, Englisch und Deutsch enthält, muss zwischen der Sprache der Antwort und der Sprache der Materialien, nach denen gesucht wird, unterschieden werden. Standardmäßig stimmen diese überein, doch der Benutzer kann beispielsweise auf Russisch fragen und deutsche Artikel anfordern. In einem solchen Fall werden Suche und Kontextentnahme (RAG) für die deutschen Materialien durchgeführt, während die finale Antwort auf Russisch generiert wird. Das ermöglicht ein einheitliches Interface bei gleichzeitiger Berücksichtigung der mehrsprachigen Struktur der Anwendung.
Besonderes Augenmerk wurde auf das Testen gelegt. Die Arbeit mit LLM bringt gewisse Schwierigkeiten mit sich: Modellantworten sind nicht immer deterministisch und zahlreiche Aufrufe an einen realen AI-Anbieter verlängern Testlaufzeiten und erhöhen Kosten.
Daher werden in automatischen Tests gesteuerte Antworten des IChatClient verwendet, mit denen die Auswahl der Werkzeuge simuliert und die Reaktion der Anwendung auf konkrete tool calls geprüft werden kann.
Integrationstests nutzen reale fachliche Dienste mit einer Test-SQLite-Datenbank, während Zugriffe auf die AI nachgebildet werden. Dieser Ansatz erlaubt das Testen von Routing, Filterung, Sicherheitsbeschränkungen und Fehlerbehandlung, ohne von der tatsächlichen Modellperformance abhängig zu sein.
Auf der Angular-Seite wird zusätzlich die korrekte Darstellung verschiedener Ergebnisarten und das Beibehalten kombinierter Antworten beim Seitenwechsel geprüft.
Als Ergebnis konnte eine relativ einfache und kontrollierbare Architektur beibehalten werden: AI ist für die Interpretation der Benutzerabsicht zuständig, bestehende Dienste führen die notwendigen Operationen aus, und die Anwendung steuert deren Reihenfolge, Grenzen und Darstellung der Ergebnisse. Die Hinzufügung intelligenter Routing-Funktionalität beeinträchtigt dabei die bereits implementierten Such- und RAG-Mechanismen kaum.
Fazit
Die Arbeit an dieser Funktionalität ermöglichte es, einen weiteren praktischen Einsatzweg großer Sprachmodelle in traditionellen Softwaresystemen zu untersuchen. Im Unterschied zu früheren Experimenten mit Textgenerierung, Embeddings und RAG lag hier das Hauptinteresse in der Nutzung von LLM zur Interpretation von Benutzerabsichten und Entscheidungsfindung.
Einer der wichtigen Schlussfolgerungen war die Erkenntnis, dass die Einführung von AI nicht zwingend erhebliche Änderungen der bestehenden Architektur oder den Einsatz komplexer Agentensysteme erfordert. Manchmal reicht eine kleine spezialisierte Komponente aus, die eine konkrete Aufgabe löst, die sich mit traditionellen Mitteln schwer umsetzen lässt.
Gleichzeitig verlangen solche Lösungen einen etwas anderen Ansatz in Entwicklung und Test. Neben der Korrektheit des Programmcodes muss die Qualität der Interpretation von Anfragen, die mögliche Variabilität im Verhalten des Modells und die Abhängigkeit des Ergebnisses von der Formulierung der Benutzeranfrage berücksichtigt werden.
Dieses Experiment war eine nützliche Fortführung der Auseinandersetzung mit AI-Technologien und ihrer praktischen Anwendung in .NET. In Zukunft wäre es wünschenswert, mehr Aufmerksamkeit der quantitativen Bewertung der Leistung von LLM, dem Vergleich verschiedener Modelle und der Suche nach Szenarien zu widmen, in denen der Einsatz von AI gegenüber traditionellen Algorithmen tatsächlich Vorteile bringt.