AI: Интеллектуальный поиск и маршрутизация запросов с помощью Tool Calling
В ходе предыдущих экспериментов с AI в проекте serdg.net были реализованы механизмы генерации embeddings, семантического поиска и RAG (Retrieval-Augmented Generation).
Благодаря этому приложение получило возможность не только находить статьи по смысловому сходству, но и формировать ответы на вопросы пользователя на основе опубликованных материалов.
Следующим этапом развития стало объединение существующих возможностей в едином интерфейсе с использованием AI Tool Calling — механизма, позволяющего языковой модели выбирать подходящие инструменты приложения в зависимости от содержания пользовательского запроса. Основная задача заключалась в том, чтобы предоставить пользователю возможность искать статьи, задавать вопросы по их содержанию и комбинировать эти операции без необходимости самостоятельно выбирать способ обработки запроса.
Выявление проблемы и постановка задачи
По мере развития проекта serdg.net постепенно расширялся набор функций для работы со статьями. Первоначально приложение предоставляло доступ к опубликованным материалам, затем появились механизмы генерации embeddings, семантического поиска и получения ответов на вопросы с использованием RAG.
В результате сформировалось несколько независимых способов взаимодействия с содержимым сайта, каждый из которых решал собственную задачу.
Однако поиск статей и генерация ответов на основе их содержания представляют собой принципиально разные операции, хотя пользователь может формулировать соответствующие запросы в одинаковой форме — на естественном языке. Например, запрос «Найди статьи о .NET на немецком языке за 2026 год» предполагает обычный поиск с фильтрацией и пагинацией, тогда как вопрос «Как использовался Azure Container Apps в проектах?» требует анализа опубликованных материалов и формирования ответа с помощью RAG. Возможен и более сложный сценарий: «Найди статьи про OpenAI и сравни описанные в них подходы». В этом случае необходимо сначала определить подходящие материалы, а затем проанализировать их содержание.
Одним из возможных решений было создание отдельных интерфейсов для поиска, контекстных вопросов и комбинированных операций. Однако такой подход потребовал бы от пользователя понимания внутренних механизмов приложения и самостоятельного выбора подходящего инструмента. Вместо этого было принято решение расширить существующее поле Any question, превратив его в универсальную точку взаимодействия с функциональностью сайта.
Основная задача заключалась в реализации механизма, способного интерпретировать пользовательский запрос и автоматически определять необходимую последовательность действий. При этом требовалось сохранить существующий RAG, добавить поиск и фильтрацию статей по естественным запросам, обеспечить поддержку комбинированных операций и повторно использовать существующие сервисы без дублирования бизнес-логики. Дополнительными требованиями стали минимизация количества обращений к LLM, контроль связанных расходов и сохранение привычного представления результатов в Angular.
Особый технический интерес представлял механизм принятия решения. Языковая модель должна определять подходящий инструмент и формировать параметры его вызова, не получая прямого доступа к базе данных или внутренней инфраструктуре приложения. Таким образом, задача сводилась не к передаче бизнес-логики под управление AI, а к созданию интеллектуального уровня маршрутизации между пользовательским интерфейсом и уже реализованными сервисами. Для решения этой задачи был выбран механизм AI Tool Calling.
Теоретическая проработка: AI Tool Calling
Для объединения различных механизмов обработки пользовательских запросов был выбран подход AI Tool Calling (также известный как Function Calling). Его основная идея заключается в том, что языковая модель не только генерирует текст, но и может определять, какие операции приложения необходимо выполнить для решения поставленной задачи. При этом сама модель не получает непосредственного доступа к бизнес-логике или инфраструктуре: она выбирает подходящий инструмент и формирует параметры его вызова, а выполнение остаётся под контролем приложения.
При обычном взаимодействии с LLM пользователь отправляет текстовый запрос, на основе которого модель генерирует ответ. В упрощённом виде этот процесс выглядит следующим образом:
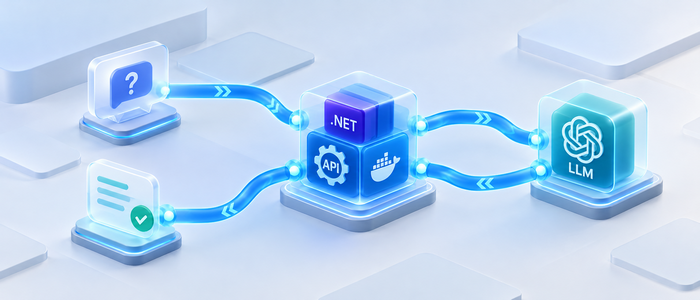
Tool Calling расширяет эту схему за счёт предоставления модели описаний доступных инструментов. Каждый инструмент имеет определённое назначение, набор параметров и правила использования. Получив пользовательский запрос, LLM сопоставляет его с описаниями инструментов и может сформировать структурированный вызов с необходимыми аргументами. Приложение проверяет полученные данные, выполняет соответствующую операцию и обрабатывает её результат. В зависимости от сценария результат может быть непосредственно возвращён пользователю либо повторно передан модели для формирования окончательного ответа.
Принципиальное отличие заключается в разделении принятия решения и выполнения операции. LLM определяет намерение пользователя и предлагает подходящий вызов, тогда как приложение самостоятельно решает, допустима ли такая операция, проверяет аргументы и обращается к соответствующему сервису. Благодаря этому языковая модель используется как интеллектуальный механизм маршрутизации, а не как замена существующей бизнес-логики.
Преимущество такого подхода особенно заметно при обработке запросов на естественном языке. Например, фразу «Покажи немецкие статьи про Docker, опубликованные за этот год» можно попытаться разобрать с помощью ключевых слов и заранее определённых правил. Однако подобная реализация быстро усложняется, поскольку одинаковые намерения могут выражаться совершенно разными формулировками, в том числе на нескольких языках. Использование LLM позволяет интерпретировать смысл запроса и преобразовать его в структурированный набор параметров:
language = "de"
  text = "Docker"
  dateFrom = "2026-01-01"
  dateTo = "2026-12-31"
После получения этих параметров дальнейшая обработка выполняется обычными сервисами приложения. Таким образом, модель отвечает за интерпретацию пользовательского намерения, а поиск, фильтрация, сортировка и пагинация остаются детерминированными операциями. Для корректной обработки относительных временных выражений, таких как «в этом году», «за прошлый месяц» или «за последние 12 месяцев», маршрутизатору дополнительно передаётся текущая дата. Это позволяет модели учитывать временной контекст запроса, хотя корректность сформированных границ по-прежнему требует проверки.
Ещё одной возможностью Tool Calling является последовательное использование нескольких инструментов. Например, для ответа на комбинированный запрос может потребоваться сначала найти подходящие статьи, затем определить релевантные фрагменты их содержимого и только после этого сформировать ответ с помощью RAG. Такие операции могут выполняться через несколько последовательных вызовов инструментов либо объединяться в заранее определённый сценарий на стороне приложения. Второй вариант особенно удобен, когда порядок выполнения известен заранее и не требует самостоятельного планирования со стороны языковой модели.
Именно поэтому для рассматриваемой задачи использование полноценного AI-агента не являлось необходимым. Количество доступных операций ограничено, их назначение заранее определено, а возможные последовательности выполнения достаточно просты. Управляемый Tool Calling с фиксированным набором инструментов позволяет получить основные преимущества интеллектуальной маршрутизации без дополнительной сложности, характерной для автономных агентных систем.
При этом Tool Calling не гарантирует абсолютной корректности обработки запросов. Языковая модель может неправильно интерпретировать намерение пользователя, выбрать неподходящий инструмент или сформировать некорректные аргументы. Дополнительную сложность создают расходы на токены, задержки при обращениях к LLM и необходимость защиты от попыток повлиять на внутреннюю логику приложения через пользовательский текст.
Поэтому надёжная реализация предполагает использование строго определённого списка доступных инструментов, обязательную валидацию аргументов, ограничения количества вызовов и контроль общего token budget. Критически важные правила должны обеспечиваться программным кодом, а не только инструкциями языковой модели. Такой подход позволяет использовать гибкость LLM для интерпретации запросов, сохраняя предсказуемость и управляемость фактического выполнения операций.
Таким образом, AI Tool Calling представляет собой механизм взаимодействия между языковой моделью и традиционными программными сервисами. Его основная ценность заключается не в передаче управления приложением искусственному интеллекту, а в возможности преобразовывать свободно сформулированные пользовательские запросы в конкретные, контролируемые операции. Именно этот принцип был положен в основу реализации интеллектуальной маршрутизации в serdg.net.
Реализация поиска и фильтрации статей
Первым практическим этапом стала подготовка механизма поиска, который мог бы использоваться как непосредственно приложением, так и через AI Tool Calling. Вместо создания отдельной реализации для языковой модели была использована существующая бизнес-логика, дополненная специализированным уровнем обработки поисковых запросов. Такой подход позволил избежать дублирования функциональности и обеспечить единые правила поиска независимо от способа его вызова.
Для передачи критериев используется структурированная модель запроса, содержащая параметры текстового поиска, языка, временного диапазона, сортировки и пагинации. Все условия могут комбинироваться в рамках одного запроса, а механизм их обработки не зависит от источника данных — пользовательского интерфейса или языковой модели.
| Параметр | Назначение |
|---|---|
text |
Текстовый поиск |
language |
Язык статьи: en, de или ru |
dateFrom |
Начальная дата |
dateTo |
Конечная дата |
sort |
Сортировка: newest или oldest |
page |
Номер страницы |
pageSize |
Размер страницы |
Полученные параметры проверяются, нормализуются и преобразуются в условия, понятные существующему механизму поиска. Упрощённый пример подготовки этих условий на C# выглядит следующим образом:
var searchParameters = new
  {
    SearchQuery = request.Text,
    LanguageCode = request.Language,
    CreatedFrom = ParseDate(request.DateFrom),
    CreatedBefore = ParseDate(request.DateTo)?.AddDays(1),
    OrderBy = request.Sort == "oldest"
      ? "CreationDate asc,Id asc"
      : "CreationDate desc,Id desc",
    IsPublished = true,
    IsHidden = false,
    Page = request.Page!.Value,
    PageSize = request.PageSize!.Value
  };
Условия поиска применяются совместно: запрос может одновременно ограничивать язык статей, содержать поисковую фразу и задавать временной интервал. Текстовое сопоставление выполняется по заголовку, краткому описанию и HTML-содержимому соответствующей локализации. В данном случае используется обычный текстовый поиск, тогда как поиск по смысловой близости остаётся задачей отдельного механизма, основанного на embeddings.
Определённые особенности имеет фильтрация по датам. Поскольку в существующей модели отсутствует отдельное поле даты публикации, поиск использует CreationDate — дату создания статьи.
Для включения конечного дня верхняя граница временного интервала преобразуется в начало следующего дня. Например, при поиске материалов до 31 декабря включительно в запрос передаётся исключающая верхняя граница 1 января следующего года.
Поскольку параметры поиска могут формироваться LLM, предусмотрен ряд ограничений. Допускаются только определённые поля и значения сортировки, а условия IsPublished = true и IsHidden = false обеспечивают выборку исключительно опубликованных и видимых статей.
Размер страницы по умолчанию составляет 20 записей, максимально допустимое значение — 50. Для стабильной пагинации сортировка по дате дополнена сортировкой по Id, позволяющей однозначно упорядочить статьи с одинаковой датой создания.
В результате был сформирован универсальный механизм поиска, одинаково доступный традиционным компонентам приложения и инструментам AI Tool Calling. При этом вся обработка данных остаётся в существующем программном слое, а языковая модель отвечает только за преобразование пользовательского запроса в структурированные параметры. Это позволяет расширять поисковые возможности без существенных изменений в архитектуре AI-интеграции.
Реализация AI Routing
После подготовки механизма поиска следующим этапом стала реализация интеллектуальной маршрутизации пользовательских запросов. Основная задача заключалась в том, чтобы на основании естественного языка определить необходимую операцию и передать её выполнение соответствующему компоненту приложения.
Для этого были определены три инструмента: SearchArticles для поиска и фильтрации статей, AskArticles для получения контекстных ответов через RAG и SearchAndAskArticles для комбинированных запросов, предполагающих сначала поиск материалов, а затем анализ их содержания.
Такой набор охватывает основные сценарии взаимодействия с приложением, не создавая избыточной сложности при выборе операции.
Маршрутизация реализована на серверной стороне с использованием IChatClient из Microsoft.Extensions.AI. Доступные инструменты регистрируются через AIFunctionFactory.CreateDeclaration, а их параметры описываются с помощью JSON Schema.
Это позволяет передать языковой модели не только названия операций, но и структуру допустимых аргументов, необходимые типы данных и назначение каждого инструмента.
При обработке запроса модель получает системные инструкции, сообщение пользователя и описания доступных инструментов. На основании этой информации она определяет подходящую операцию и формирует структурированные аргументы для её выполнения. Упрощённый пример конфигурации обращения к LLM выглядит следующим образом:
var response = await client.GetResponseAsync(
    state.Messages,
    new ChatOptions
    {
      Tools = Tools,
      AllowMultipleToolCalls = false,
      MaxOutputTokens = limits.MaxOutputTokens,
      ResponseFormat = ChatResponseFormat.Json
    },
    ct);
Важной особенностью является то, что выбор инструмента и его фактическое выполнение разделены. Модель формирует запрос на вызов определённой операции, после чего приложение проверяет полученные параметры и самостоятельно выполняет необходимые действия. Результат может быть возвращён пользователю непосредственно либо использован для дальнейшей обработки.
Работу этого механизма удобно рассмотреть на примере запроса: «Найди статьи про Azure Container Apps на русском языке и объясни, как в них организовано развёртывание приложений». В данном случае пользователь ожидает одновременно список подходящих материалов и объяснение на основе их содержания.
Следовательно, наиболее подходящей операцией является SearchAndAskArticles. В упрощённом представлении выбор модели и сформированные аргументы могут выглядеть следующим образом:
{
    "tool": "SearchAndAskArticles",
    "arguments": {
    "text": "Azure Container Apps",
    "language": "ru",
    "sort": "newest"
    }
  }
После получения и проверки аргументов приложение выполняет поиск статей в соответствии с заданными условиями. Затем идентификаторы найденных материалов передаются механизму RAG, ограничивая область дальнейшего поиска релевантных фрагментов. Таким образом, сначала формируется выборка статей, соответствующая пользовательскому запросу, и только после этого выполняется семантический поиск внутри неё. Это обеспечивает согласованность результатов: сгенерированный ответ основывается на материалах, удовлетворяющих исходным критериям поиска.
Поскольку различные инструменты предполагают разные способы представления информации, сервер возвращает структурированный результат с указанием его типа в поле resultType. Для обычного поиска используется SearchResult, содержащий список статей и данные пагинации.
Контекстный вопрос возвращает AnswerResult с текстом ответа и ссылками на источники. Комбинированная операция формирует CombinedResult, объединяющий обе структуры.
Упрощённый пример структуры комбинированного ответа:
{
    "resultType": "CombinedResult",
    "status": "answered",
    "answer": "...",
    "sources": [],
    "articles": {
    "items": [],
    "totalItems": 0,
    "page": 1,
    "pageSize": 20,
    "totalPages": 0
    },
    "search": {
    "text": "Azure Container Apps",
    "language": "ru",
    "sort": "newest",
    "page": 1,
    "pageSize": 20
    },
    "coverageLimited": true
  }
Приведённая структура демонстрирует принцип объединения результатов поиска и генерации ответа; содержимое полей answer, sources и articles зависит от фактически найденных материалов.
Дополнительно возвращаются нормализованные параметры поиска, которые могут повторно использоваться клиентом, например при переключении страниц. Поле coverageLimited позволяет обозначить, что сгенерированный ответ основан на ограниченной выборке материалов.
Для интеграции с Angular существующее поле Any question было подключено к новому серверному endpoint, поддерживающему все три сценария.
Полученный resultType определяет способ отображения информации: результаты поиска представляются карточками статей, контекстные ответы — текстом со ссылками на источники, а комбинированный результат содержит оба элемента одновременно.
При этом поисковая выдача не преобразуется языковой моделью в обычный текст. Для её отображения повторно используются существующие компоненты Angular, благодаря чему сохраняются привычный внешний вид карточек и механизмы навигации. Генерация текста применяется только там, где действительно требуется анализ содержания материалов.
В результате AI Routing объединил несколько независимых возможностей приложения в едином пользовательском интерфейсе. Языковая модель определяет намерение пользователя и выбирает подходящий инструмент, тогда как выполнение поиска, извлечение контекста и формирование результатов остаются за специализированными механизмами. Это позволяет использовать преимущества естественного языка без изменения основных принципов работы существующего приложения.
Архитектурные решения и интересные особенности реализации
При реализации нового функционала основной задачей было максимально использовать существующую архитектуру приложения, сохранив разделение ответственности между компонентами. В результате ArticleRequestRouter отвечает за интерпретацию запроса и выбор подходящего инструмента, ArticleQueryService выполняет поиск и фильтрацию статей, а ArticleAnswerService обеспечивает работу с RAG. Такое разделение позволяет развивать каждый компонент независимо, упрощает тестирование и даёт возможность добавлять новые инструменты без существенных изменений в существующей бизнес-логике.
Одним из наиболее важных решений стало ограничение области поиска RAG при обработке комбинированных запросов. Для этого используется объект RagSearchScope, содержащий язык и идентификаторы статей, среди которых необходимо искать информацию:
public sealed record RagSearchScope(string Language,IReadOnlyList<int> TopicIds);После выполнения обычного поиска в этот объект передаются идентификаторы статей с текущей страницы выдачи. Далее RAG ищет релевантные фрагменты исключительно среди выбранных материалов. Причём фильтрация выполняется ещё до сортировки по векторной близости и выбора top-K фрагментов. Таким образом, найденная информация относится к статьям, соответствующим исходным критериям поиска. Отдельно предусмотрена обработка пустой выборки: если подходящие статьи отсутствуют, RAG не переключается автоматически на всю базу знаний.
Поскольку выбор инструментов выполняется языковой моделью, необходим контроль её действий. ArticleRequestRouter проверяет имена вызываемых инструментов и передаваемые аргументы, отклоняя неизвестные операции и некорректные параметры.
Взаимодействие ограничено четырьмя раундами обращения к маршрутизирующей модели, одним tool call на раунд и максимум тремя вызовами инструментов. Дополнительно контролируются входные и выходные токены, общий token budget, время выполнения и частота запросов.
Эти ограничения обеспечивают предсказуемость поведения приложения, снижают риски некорректного использования инструментов и позволяют контролировать расходы на AI.
С этой же целью была оптимизирована работа с пагинацией. После первоначального запроса система уже располагает структурированными параметрами поиска, полученными с помощью LLM. Поэтому при переходе на следующую страницу нет необходимости повторно обращаться к модели и интерпретировать тот же запрос.
Вместе с результатами клиент получает нормализованные фильтры, которые используются при последующих запросах с изменённым номером страницы. ArticleRequestRouter распознаёт такой сценарий и напрямую обращается к ArticleQueryService, минуя LLM. В результате уменьшаются задержки и расход токенов.
Если первоначальный запрос был комбинированным, сгенерированный ответ также сохраняется при переключении страниц и не вычисляется повторно.
Однако у такого подхода есть важное ограничение. Комбинированный ответ формируется на основе статей с текущей страницы поисковой выдачи, а RAG дополнительно отбирает из них наиболее релевантные фрагменты с учётом доступного token budget.
Следовательно, полученный ответ нельзя считать исчерпывающим анализом всех найденных материалов. Чтобы явно обозначить это ограничение, в модель результата добавлен флаг coverageLimited. Если он установлен в true, Angular отображает соответствующее уведомление.
Это важный аспект проектирования AI-интерфейсов: пользователь должен понимать не только результат обработки запроса, но и границы информации, на которой этот результат основан.
Ещё одной особенностью стала поддержка нескольких языков. Поскольку serdg.net содержит статьи на русском, английском и немецком, необходимо различать язык ответа и язык материалов, по которым выполняется поиск. По умолчанию они совпадают, однако пользователь может, например, задать вопрос на русском языке и запросить немецкие статьи. В таком случае поиск и извлечение контекста RAG выполняются для немецких материалов, а итоговый ответ формируется на русском языке. Это позволяет сохранить единый интерфейс и одновременно учитывать многоязычную структуру приложения.
Отдельное внимание было уделено тестированию. Работа с LLM создаёт определённые сложности: ответы модели не всегда детерминированы, а многочисленные обращения к реальному AI-провайдеру увеличивают время выполнения тестов и расходы.
Поэтому в автоматических тестах используются управляемые ответы IChatClient, позволяющие моделировать выбор инструментов и проверять реакцию приложения на конкретные tool calls.
Интеграционные тесты используют реальные прикладные сервисы с тестовой базой SQLite, тогда как обращения к AI имитируются. Такой подход позволяет проверять маршрутизацию, фильтрацию, ограничения безопасности и обработку ошибок без зависимости от поведения реальной модели.
На стороне Angular дополнительно проверяется корректное отображение различных типов результатов и сохранение комбинированного ответа при переключении страниц.
В результате удалось сохранить достаточно простую и контролируемую архитектуру: AI отвечает за интерпретацию пользовательского намерения, существующие сервисы выполняют необходимые операции, а приложение управляет их последовательностью, ограничениями и представлением результатов. При этом добавление интеллектуальной маршрутизации практически не затрагивает уже реализованные механизмы поиска и RAG.
Заключение
Работа над этой функциональностью позволила на практике изучить ещё один способ применения больших языковых моделей в традиционных программных системах. В отличие от предыдущих экспериментов с генерацией текста, Embeddings и RAG, здесь основной интерес представляло использование LLM для интерпретации пользовательских намерений и принятия решений.
Одним из важных выводов стало понимание того, что внедрение AI не обязательно требует существенного изменения существующей архитектуры или использования сложных агентных систем. Иногда достаточно небольшого специализированного компонента, решающего конкретную задачу, которую затруднительно реализовать традиционными средствами.
В то же время подобные решения требуют несколько иного подхода к разработке и тестированию. Помимо корректности программного кода, необходимо учитывать качество интерпретации запросов, возможную вариативность поведения модели и зависимость результата от формулировки пользовательского запроса.
Этот эксперимент стал полезным продолжением знакомства с технологиями AI и их практическим применением в .NET. В дальнейшем хотелось бы уделить больше внимания количественной оценке качества работы LLM, сравнению различных моделей и поиску сценариев, в которых применение AI действительно даёт преимущества перед традиционными алгоритмами.